
راهنمای جامع ارزیابی و انتخاب مدلهای Frontier و مدلهای برنامهنویسی
بهروزرسانی: ۲۸ اکتبر ۲۰۲۶ (۶ آبان ماه ۱۴۰۵ ) | مخاطب: توسعهدهندگان نرمافزار، معماران سیستم و مدیران فنی | این مقاله تاریخچه مدلهای ناشناس را بررسی نمیکند و بر انتخاب فنی و اقتصادی تمرکز دارد.
چکیده اجرایی
یک مدل ممکن است در نوشتن تابع عالی باشد، اما هنگام تغییر دهها فایل، اجرای تست و اصلاح خطا عملکرد ضعیفی داشته باشد. انتخاب مدل مناسب مستلزم بررسی سه چیز است: توانایی مدل، محیط Agent و هزینه واقعی تکمیل موفق کار. درصدهای منتشرشده از اجراهای متفاوت الزاماً قابل مقایسه نیستند.
۱. تفاوت مدل برنامهنویسی با Agent برنامهنویسی
Coding model مدل زبانی است که کد را میخواند یا تولید میکند. Reasoning model برای حل مسائل چندمرحلهای بهینه شده است. Coding agent یک سیستم اجرایی است که مدل را به ابزارهایی مثل خواندن فایل، جستوجوی مخزن، ترمینال و تست متصل میکند. Cline، Cursor، Claude Code و Codex محیط/محصول Agent هستند؛ امتیاز Agent لزوماً امتیاز خود مدل نیست.
مثال: درخواست «خطای ورود را رفع کن» برای یک مدل ساده میتواند فقط یک قطعه کد تولید کند؛ Agent باید فایلهای مرتبط را پیدا کند، اصلاح انجام دهد، تست اجرا کند، خطا را تحلیل و نتیجه را گزارش کند.
۲. بنچمارکها چگونه کار میکنند؟
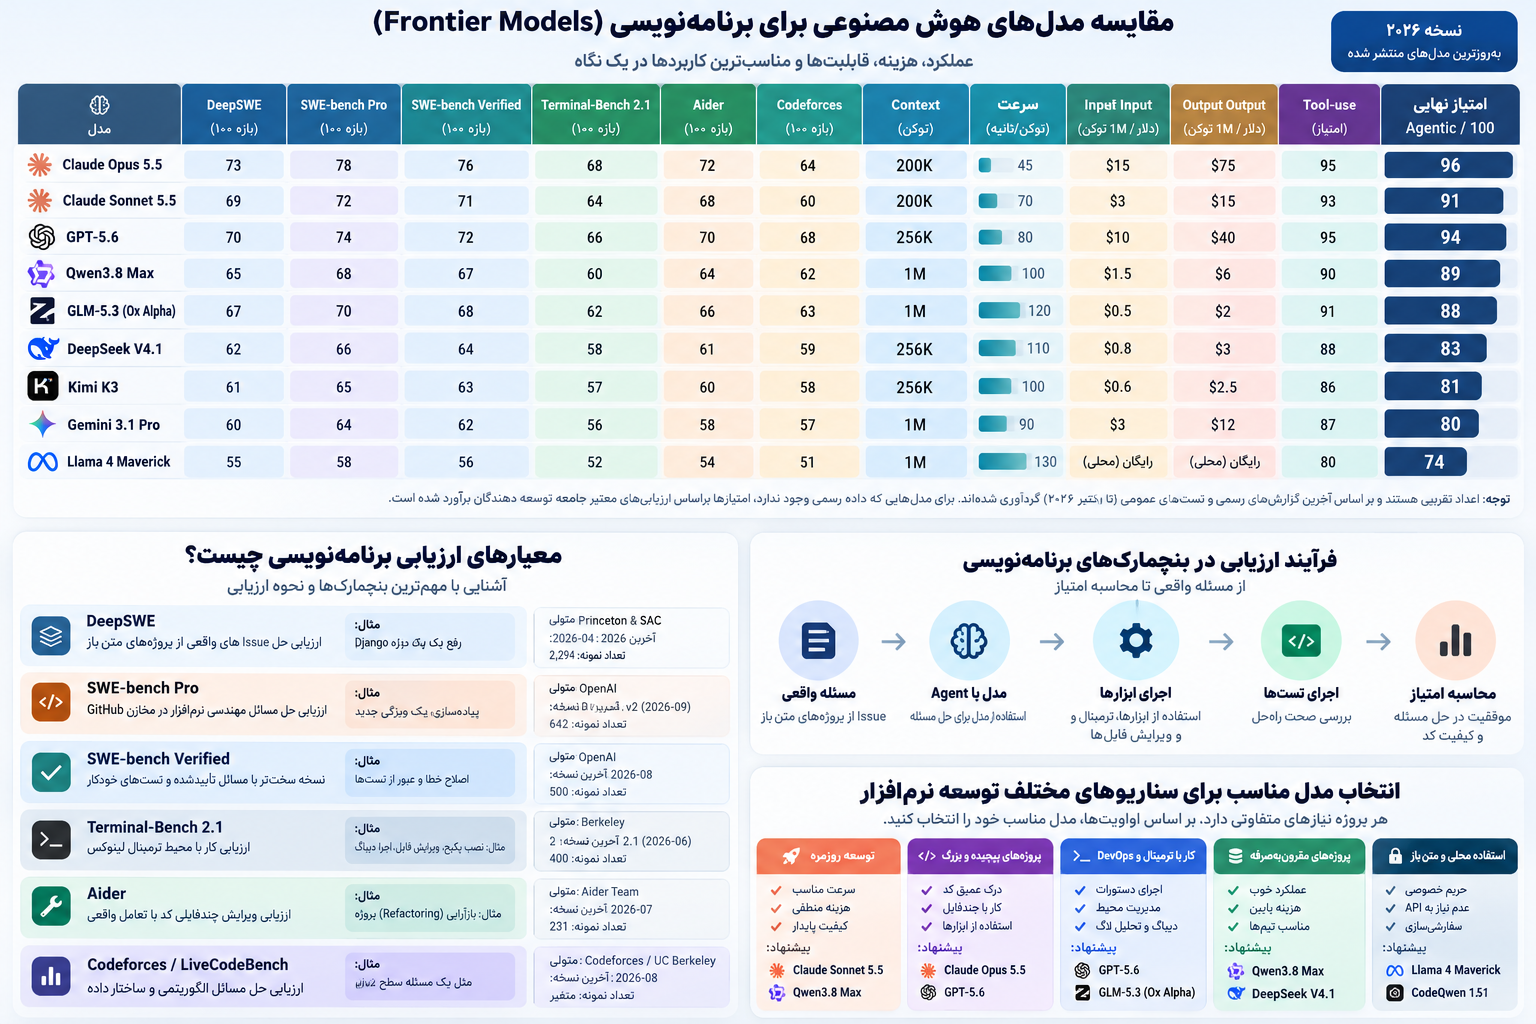
| بنچمارک / متولی | نسخه یا مجموعه معتبر | روش ارزیابی | مثال و محدودیت |
|---|---|---|---|
| SWE-bench / پژوهشگران Princeton و جامعه SWE-bench | Original: ۲۲۹۴ مسئله؛ Lite: ۳۰۰؛ Verified: ۵۰۰ | Issue واقعی GitHub، ساخت محیط، اعمال patch، اجرای تست و محاسبه درصد مسائل حلشده | رفع bug در مخزن Python؛ به کیفیت تست و نشت داده حساس است. |
| SWE-bench Multilingual / SWE-bench | ۳۰۰ مسئله؛ ۹ زبان؛ ۴۲ مخزن | همان منطق حل Issue با زبانها و مخزنهای متنوع | برای پروژههای غیر Python مفیدتر از Verified اولیه. |
| SWE-bench Pro / Scale AI | Pro V2، ۲۲ سپتامبر ۲۰۲۶؛ ۶۴۲ مسئله در ۱۱ مخزن | وظایف دشوار و بلندمدت، اجرای محدودتر و بازآزمایی patch در محیط تمیز | تغییر چندماژولی؛ با نسخه قدیمی Pro یکسان نیست. |
| Terminal-Bench / گروه Terminal-Bench | ۲.۱؛ اصلاح ۲۸ مسئله از ۸۹ مسئله ۲.۰ | دستور، محیط Docker و اسکریپت تست؛ Agent با shell کار میکند | نصب dependency و عیبیابی سرویس؛ harness بر نتیجه اثر میگذارد. |
| LiveCodeBench / گروه پژوهشی LiveCodeBench | مجموعه پیوسته مسائل مسابقاتی؛ نسخه/بازه تاریخ باید ثبت شود | مسائل تازه LeetCode، AtCoder و Codeforces؛ تولید کد و بعضاً self-repair | حل الگوریتم؛ شاخص مستقیمی برای نگهداری repository نیست. |
| Aider Polyglot / پروژه Aider | نسخه و commit مجموعه باید کنار نتیجه درج شود | درخواست ویرایش کد در زبانهای مختلف و اجرای تست | ویرایش چندفایلی؛ وابسته به نسخه Aider و تنظیمات. |
| HumanEval / OpenAI | HumanEval؛ و HumanEval+ از EvalPlus | تولید تابع بر اساس docstring و قبولی unit test | خوب برای کدنویسی کوتاه؛ نه مدیریت پروژه. |
| OSWorld / پژوهشگران OSWorld | نسخه ۲.۰ در منابع ارزیابی ۲۰۲۶ | انجام کار با محیط گرافیکی کامپیوتر | برای automation مفید است اما benchmark اختصاصی coding نیست. |
| FrontierML / گروه FrontierML | Leaderboard پویا در اکتبر ۲۰۲۶ | Agent باید آزمایش یادگیری ماشین را با بودجه محدود انجام دهد | برای ML engineering مناسب، نه نماینده همه وظایف توسعه وب. |
| DeepSWE / مجموعههای مستقل | در گزارشها DeepSWE 1.1؛ پروتکل هر نتیجه را کنترل کنید | وظایف پیچیدهتر توسعه نرمافزار و اجرای چندمرحلهای | بدون یکسانسازی نسخه و harness امتیازها قابل ادغام نیستند. |
۳. خواندن صحیح امتیازها
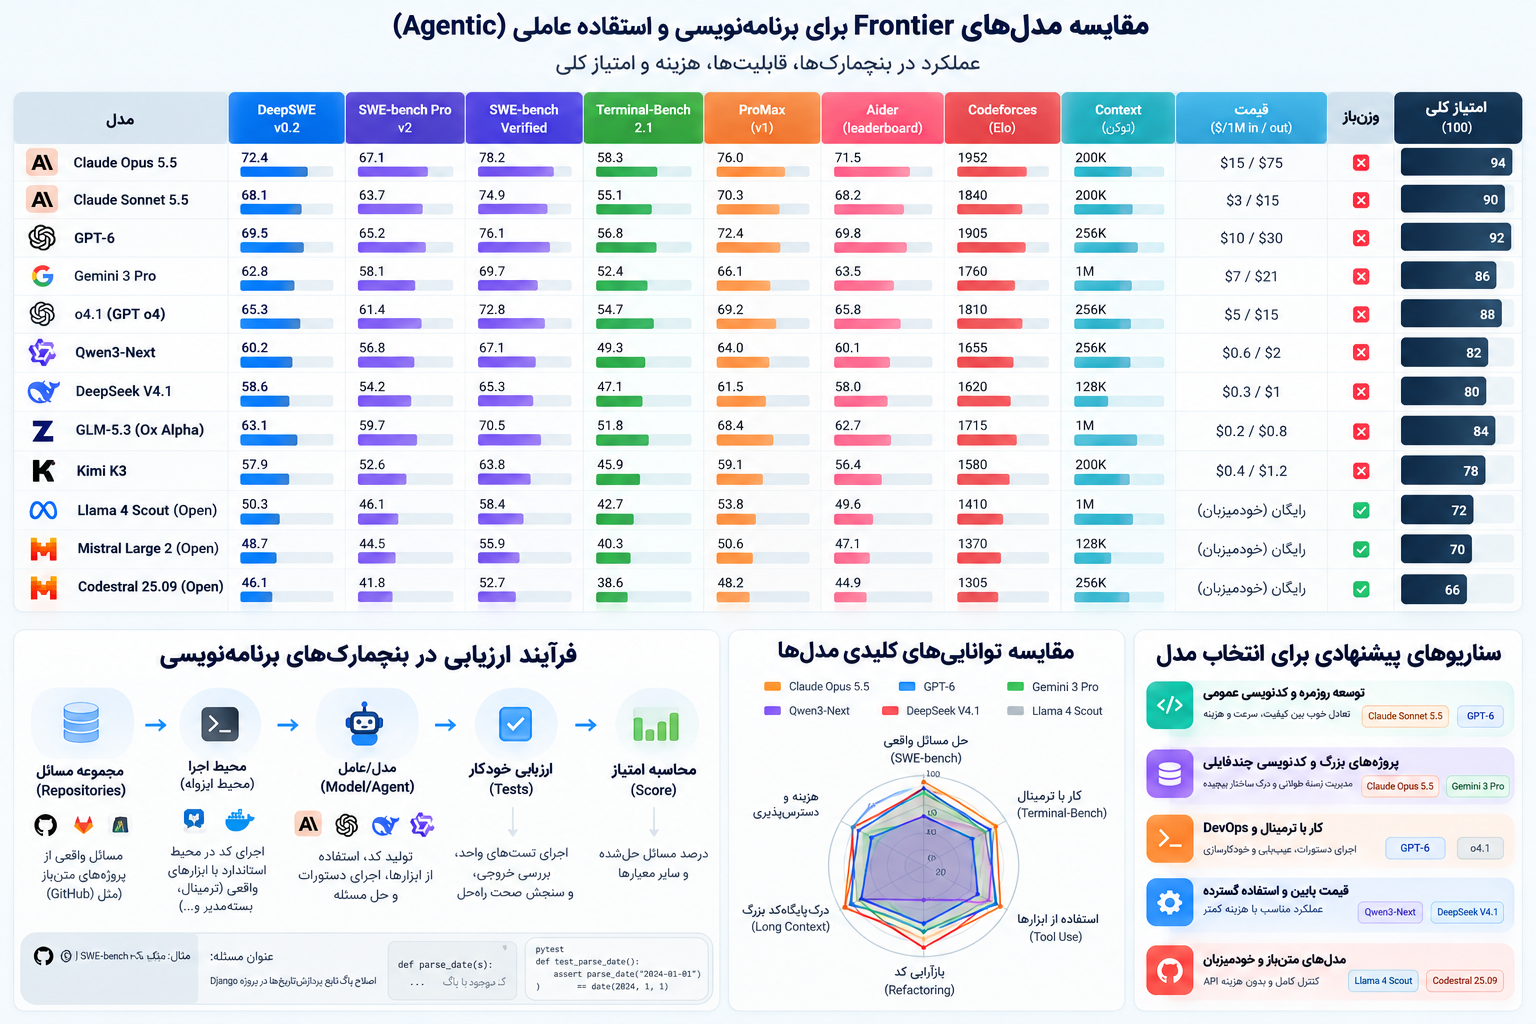
Resolved rate = تعداد مسائل حلشده تقسیم بر تعداد کل مسائل. Pass@1 احتمال موفقیت در یک تلاش است. Pass@k احتمال موفقیت با چند تلاش است و معمولاً بزرگتر میشود. در agentic benchmark باید نسخه dataset، نسخه مدل، harness، ابزارهای مجاز، budget، reasoning effort، تعداد تکرار و فاصله اطمینان ثبت شود.
مثال فرضی: Agent A در ۱۰۰ مسئله، ۶۵ مورد را با هزینه متوسط ۲ دلار حل میکند؛ Agent B تعداد ۶۰ مورد را با هزینه ۰٫۴ دلار. A از نظر نرخ موفقیت بهتر است، اما B ممکن است برای وظایف تکراری اقتصادیتر باشد. این اعداد آموزشیاند، نه نتایج واقعی مدلها.
۴. کدام مدلها را در فهرست انتخاب قرار دهیم؟
| خانواده/مدل نمونه | دسترسی به وزنها | کاربرد غالب | نکته تصمیمگیری |
|---|---|---|---|
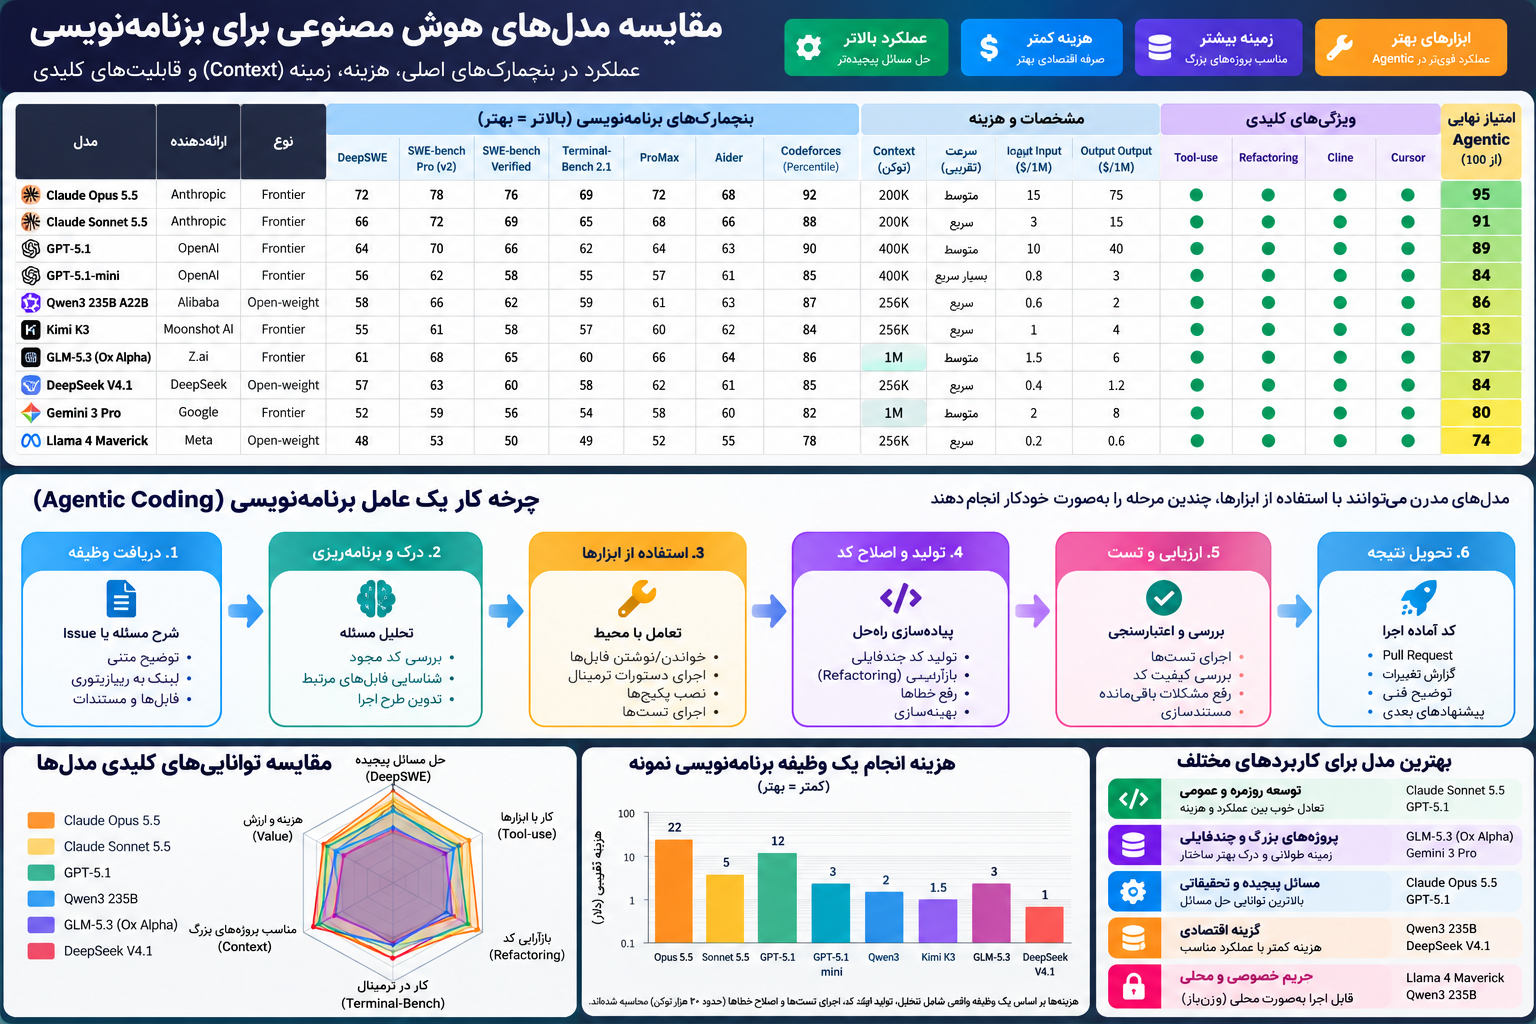
| Claude Opus / Sonnet (نسخههای ۵ و ۵.۵) | اختصاصی | بازآرایی پیچیده، توسعه Agentic | قیمت و محدودیت context را از API رسمی نسخه دقیق بگیرید. |
| GPT-6 / GPT-6.1 و مدلهای coding OpenAI | اختصاصی | حل مسئله، معماری، ابزار و توسعه نرمافزار | نسخه Sol/Luna و سطح reasoning را جداگانه ارزیابی کنید. |
| Gemini 3.x / Gemini 4 | اختصاصی | مخزن بزرگ و ورودی چندرسانهای | اندازه context اسمی با بازیابی مؤثر یکسان نیست. |
| Qwen3.8 Max و Qwen Coder | بسته به مدل؛ Max اختصاصی، برخی Coderها وزنباز | تولید کد و Agentic coding | مجوز هر checkpoint را جداگانه بررسی کنید. |
| GLM-5.3 و خانواده GLM | بسته به نسخه و مجوز | Agentic coding و گزینههای اقتصادی | ارزیابی API با اجرای محلی یکی نیست. |
| DeepSeek V4.x | بسته به نسخه | استدلال و توسعه کمهزینهتر | دسترسی وزن، هزینه و محدودیت provider را تأیید کنید. |
| Kimi K3 / K3.1 | بسته به نسخه | کار طولانی با ابزار | هزینه output و پایداری tool call مهم است. |
| MiniMax M3.x | بسته به نسخه | Coding agent و کارهای تکراری | با task واقعی و هزینه تکمیل بسنجید. |
| Mistral / Devstral | بعضی نسخهها وزنباز | اجرای محلی و کار با مخزن | VRAM و مجوز تجاری تعیینکنندهاند. |
وزنباز (Open weights) یعنی پارامترهای مدل قابل دریافتاند؛ این الزاماً به معنای متنباز بودن داده آموزش، کد آموزش یا مجوز استفاده نامحدود تجاری نیست. حتی مدل وزنباز ممکن است برای اجرای عملی به چند GPU یا کوانتیزاسیون نیاز داشته باشد.
۵. نمونه نتایج منتشرشده: فقط در پروتکل مشخص
جدول زیر نمونهای از اعداد گزارششده در صفحه رسمی Qwen3.8 است؛ این اعداد گزارش سازندهاند و الزاماً آزمون مستقل یا نتیجه Cline/Cursor نیستند. از مقایسه آن با SWE-bench Pro V2 یا اجرای متفاوت Terminal-Bench خودداری کنید.
| مدل | Terminal-Bench 2.1 (%) | SWE-bench Pro (%) | DeepSWE 1.1 (%) |
|---|---|---|---|
| Qwen3.8 Max | 86.6 | 67.7 | 56.6 |
| Qwen3.7 Max | 74.5 | 60.6 | 21.6 |
| GPT-5.6 Sol (max) | 88.8 | 64.6 | 73.0 |
| Claude Fable 5 | 84.6 | 80.0 | 70.0 |
| Claude Opus 4.8 | 84.6 | 69.2 | 59.0 |
این جدول عمداً شامل همه مدلهای روز نیست: نبود نتیجه معتبر برای نسخه دقیق، به معنی ضعیف بودن مدل نیست. رتبهبندی قطعی از ترکیب خودسرانه امتیازهای ناهمسان علمی نیست.
۶. قیمت، سرعت و context را چطور مقایسه کنیم؟
قیمت API را با واحد دلار به ازای یک میلیون توکن ورودی و خروجی، تاریخ و provider ثبت کنید. cache read/write، reasoning tokens، محدودیت نرخ، latency اولین توکن و throughput خروجی میتوانند هزینه واقعی را تغییر دهند. قیمتها پویا هستند؛ بهجای اعداد قدیمی، لینک صفحه رسمی قیمت هر مدل را در روز انتشار کنترل کنید.
هزینه تقریبی یک کار = (توکن ورودی × نرخ ورودی + توکن خروجی × نرخ خروجی) / ۱٬۰۰۰٬۰۰۰؛ هزینه ابزار، تکرار، cache و هزینه زیرساخت جداگانه افزوده میشود. شاخص کاربردیتر «هزینه به ازای task موفق» است.
Context window بزرگ بهتنهایی تضمین فهم مخزن بزرگ نیست؛ کیفیت جستوجوی فایل، انتخاب context، خلاصهسازی، retrieval و محدودیت خروجی نیز اهمیت دارند. سرعت را با median و p95 latency در یک workload یکسان بسنجید.
۷. آیا امتیاز ۱۰۰ نمرهای واحد علمی است؟
خیر. اگر برای انتخاب داخلی به امتیاز مرکب نیاز دارید، باید آن را «شاخص تصمیم سازمان» بنامید، نه بنچمارک رسمی. پیشنهاد وزنها: حل Issue واقعی ۲۵، وظایف ترمینال ۲۰، تغییر چندفایلی ۱۵، قابلیت اعتماد ابزار ۱۰، کیفیت تست ۱۰، هزینه task موفق ۱۰، سرعت ۵ و امنیت/حاکمیت داده ۵. هر بعد باید با مجموعه task ثابت و امتیاز ۰ تا ۱۰۰ نرمال شود؛ داده ناموجود را با حدس پر نکنید.
۸. انتخاب مدل بر اساس سناریو
| سناریو | اولویت اصلی | روش آزمایش |
|---|---|---|
| توسعه روزانه در Cursor/Cline | نرخ موفقیت، latency و هزینه | ۲۰ issue واقعی با محدودیت زمانی یکسان |
| Refactoring چندماژولی | حفظ رفتار و پوشش تست | تست رگرسیون + بررسی diff |
| Backend با FastAPI/PostgreSQL | migration، قرارداد API، rollback | تست integration و migration روی DB آزمایشی |
| Frontend React | تغییر UI، build و accessibility | Playwright و تست تصویری |
| کد محرمانه یا داده حساس | حاکمیت داده، محل پردازش و مجوز | بررسی قرارداد provider یا اجرای محلی |
| اجرای لوکال با GPU | VRAM، quantization، سرعت و کیفیت | بنچمارک روی سختافزار واقعی |
۹. یک آزمون عملی قابل تکرار برای تیم توسعه
۱۰ تا ۳۰ مسئله واقعی و ناشناخته برای مدل انتخاب کنید؛ repo را در commit ثابت قرار دهید؛ برای همه مدلها یک harness و بودجه برابر تعریف کنید؛ تستها را در container جدا اجرا کنید؛ success، زمان، تعداد tool call، توکن، هزینه، خطا و دخالت انسانی را ثبت کنید. حداقل سه بار اجرا و نتایج میانگین/پراکندگی را گزارش کنید. در نهایت هم «درصد حل موفق» و هم «هزینه هر مسئله حلشده» را نشان دهید.
۱۰. جمعبندی
برای انتخاب مدل برنامهنویسی، یک leaderboard کافی نیست. SWE-bench مسئله واقعی repository را میسنجد؛ Terminal-Bench مهارت اجرایی در محیط ترمینال را؛ LiveCodeBench توان حل الگوریتم را؛ و benchmarkهای تخصصیتر ابعاد دیگری را. مدل برتر برای تیم شما مدلی است که در مخزن، ابزار، بودجه، زبان برنامهنویسی و سیاست امنیتی شما بیشترین کار موفق را با هزینه قابل قبول انجام دهد.